Black hat SEO: o que o Google considera spam na Pesquisa
Black hat SEO é o nome de mercado para as práticas que tentam manipular a classificação na Pesquisa Google em vez de merecê-la. Cada uma delas tem nome próprio nas políticas de spam da Pesquisa: cloaking, abuso de doorways, excesso de palavras-chave, spam por links, abuso de conteúdo em escala e mais uma dúzia.
São dezesseis políticas nomeadas, mais quatro práticas que também levam a rebaixamento ou remoção. Este texto mapeia todas elas na versão da documentação consultada em 2 de setembro de 2026, mostra o que mudou em 2026 e explica como distinguir uma ação manual de um rebaixamento algorítmico.
O que é black hat SEO?
Black hat SEO é qualquer técnica adotada com o objetivo principal de manipular os sistemas de classificação de um mecanismo de busca, em oposição a otimizar um site para que ele seja genuinamente a melhor resposta. O termo vem da cultura de segurança da informação e se popularizou no mercado de SEO nos anos 2000, junto com white hat SEO, que se refere às práticas corretas, e grey hat SEO, para o que fica na zona cinzenta entre as duas.
A documentação do Google não organiza o assunto por esse vocabulário, ela nomeia cada prática individualmente dentro das políticas de spam, o que na prática é mais útil, porque transforma uma discussão de rótulo em uma lista verificável.
A definição oficial de spam está logo na abertura das políticas e mudou de escopo recentemente. Hoje ela diz que spam se refere a técnicas usadas para enganar os usuários ou manipular os sistemas de pesquisa para destacar o conteúdo, incluindo tentar classificar o conteúdo com uma alta posição ou manipular as respostas da IA generativa na Pesquisa Google. A parte nova é essa segunda metade da frase. Ela coloca a manipulação de respostas de IA no mesmo nível da manipulação de ranqueamento, e vale para as superfícies generativas da Pesquisa, como o AI Overview e o AI Mode.
Quais são as políticas de spam da Pesquisa Google?
São dezesseis políticas nomeadas, mais uma seção final com quatro outras práticas que podem levar a rebaixamento ou remoção. A tabela abaixo lista todas, com o nome em português e o nome em inglês, porque a maior parte da discussão técnica e das ferramentas usa os termos em inglês.
| Política | Nome em inglês | O que é |
|---|---|---|
| Técnicas de cloaking | Cloaking | Apresentar conteúdo diferente para usuários e mecanismos de busca com intenção de manipular a classificação |
| Abuso de doorways | Doorway abuse | Páginas ou sites criados para ranquear em consultas semelhantes, que levam a páginas intermediárias menos úteis que o destino final |
| Abuso de domínio expirado | Expired domain abuse | Comprar um domínio expirado e reaproveitá-lo para manipular classificação com conteúdo de pouco valor |
| Conteúdo invadido | Hacked content | Conteúdo inserido no site sem permissão, por vulnerabilidade de segurança |
| Abuso de texto e link oculto | Hidden text and link abuse | Conteúdo colocado na página apenas para o mecanismo de busca, sem ficar visível para quem visita |
| Excesso de palavras-chave | Keyword stuffing | Preencher a página com palavras-chave ou números para manipular a classificação |
| Spam por links | Link spam | Criar links de ou para um site com o objetivo principal de manipular a classificação |
| Tráfego gerado por máquina | Machine-generated traffic | Enviar consultas automatizadas ao Google sem permissão expressa, inclusive raspar resultados para verificar posição |
| Práticas mal-intencionadas | Malicious practices | Malware, software indesejado e sequestro do botão Voltar |
| Funcionalidade enganosa | Misleading functionality | Prometer um conteúdo ou serviço que a página não entrega, levando o usuário a anúncios enganosos |
| Abuso de conteúdo em escala | Scaled content abuse | Gerar muitas páginas de conteúdo não original com o objetivo principal de manipular a classificação |
| Raspagem de dados | Scraping | Copiar conteúdo de outros sites e hospedá-lo para manipular a classificação |
| Abuso de reputação do site | Site reputation policy | Publicar conteúdo de terceiros em um site host para aproveitar os indicadores de classificação já estabelecidos dele |
| Redirecionamentos não autorizados | Sneaky redirects | Redirecionar de forma maliciosa, para enganar o usuário ou o mecanismo de busca |
| Afiliação sem valor agregado | Thin affiliation | Páginas com links de afiliado cujas descrições e avaliações são copiadas do comerciante, sem valor agregado |
| Spam gerado pelo usuário | User-generated spam | Spam inserido por usuários em canais abertos a conteúdo de terceiros |
As quatro outras práticas da seção final são remoções judiciais, remoções de informações pessoais, evasão da política e golpe e fraude. Elas funcionam de maneira diferente das dezesseis anteriores: em vez de descrever uma técnica de manipulação, descrevem situações em que o Google rebaixa ou remove conteúdo por acúmulo de pedidos válidos de remoção, por padrão de comportamento abusivo ou por tentativa reiterada de contornar as políticas.
Duas ressalvas importam para ler a lista corretamente. A primeira é que as consequências declaradas são classificação mais baixa ou ausência dos resultados, e o documento não promete gradação além disso. A segunda é que a lista não é exaustiva, o próprio texto afirma que as políticas abrangem práticas comuns de spam, mas que o Google pode agir contra qualquer tipo de prática de spam que detectar.
Concluir que algo é permitido porque não está nomeado é uma leitura que o documento não autoriza.
Cloaking: conteúdo diferente para o Google e para o usuário
Cloaking é apresentar conteúdo diferente para usuários e para mecanismos de busca com a intenção de manipular a classificação e enganar quem pesquisa.
Os dois exemplos que a documentação dá são mostrar uma página sobre destinos de viagem para o mecanismo de busca enquanto o usuário vê uma página sobre medicamentos com desconto, e inserir texto ou palavras-chave em uma página apenas quando o user agent que a solicita é um mecanismo de busca.
O que sustenta essa política é intenção. O conceito de cloaking está no propósito, a diferença entre cloaking e entrega adaptada legítima está no propósito, não no fato técnico de existirem duas respostas possíveis.
Isso importa porque a maioria dos sites entrega conteúdo diferente para agentes diferentes todos os dias, sem violar nada. Se o site usa tecnologias que os mecanismos de busca têm dificuldade para acessar, como JavaScript ou imagens, a orientação é seguir as recomendações de tornar esse conteúdo acessível a máquinas e pessoas, e não construir uma versão paralela para o robô. O problema nesses casos quase sempre é renderização e não malícia.
O paywall é a exceção explicitada. Operar um paywall ou um mecanismo de acesso controlado não é considerado cloaking se o Google puder ver todo o conteúdo por trás do bloqueio, como qualquer pessoa que tenha acesso ao material, e se o site seguir as orientações gerais de amostragem flexível. A regra prática é que o Googlebot deve ver o mesmo que o assinante vê, não mais do que isso.
Há um caso de cloaking que não é escolha do dono do site. Hackers costumam usar a técnica justamente para que o proprietário não perceba que o site foi invadido, servindo a página limpa para quem administra e a página com spam para o mecanismo de busca. É por isso que cloaking aparece também como exemplo de injeção de conteúdo dentro da política de conteúdo invadido. Se o site mostra sinais de posicionar para termos que ninguém publicou ali, a primeira hipótese é invasão, não penalidade.
Outras práticas mais usadas
Keyword stuffing, ou excesso de palavras-chave
Excesso de palavras-chave, conhecido no mercado pelo termo em inglês keyword stuffing, é preencher a página com palavras-chave ou números para manipular a classificação. O padrão típico são palavras aparecendo em lista ou em grupo, de maneira não natural ou fora de contexto. Exemplos comuns são listas de números de telefone sem valor substancial, blocos de texto que enumeram cidades e regiões que a página tenta alcançar, e repetição da mesma expressão de forma artificial.
O critério aqui é a naturalidade do texto, não uma densidade numérica. Não existe percentual de repetição publicado pelo Google, e ferramentas que sugerem uma faixa ideal de densidade estão oferecendo uma convenção de mercado, não um limite oficial. O teste utilizável é ler o parágrafo em voz alta: se a repetição incomoda quem lê, ela também não ajuda a ranquear.
Abuso de doorways
Abuso de doorways acontece quando sites ou páginas são criados para ranquear em consultas de pesquisa específicas e semelhantes, levando o usuário a páginas intermediárias menos úteis que o destino final. Aqui encontramos exemplos em quatro formatos:
- vários sites com pequenas variações de URL e de home para maximizar alcance em uma consulta,
- várias páginas ou domínios segmentados por região ou cidade que afunilam para uma única página,
- páginas geradas para empurrar o visitante até a parte realmente utilizável do site, e
- páginas consideravelmente semelhantes que ficam mais próximas de uma página de resultados que de uma hierarquia navegável.
O terceiro e o quarto formatos são os que pegam sites bem-intencionados. Uma matriz de páginas do tipo serviço mais cidade, gerada em escala para cobrir combinações, cai no segundo e no quarto formato ao mesmo tempo se as páginas diferirem apenas pelo nome do município. A fronteira é conteúdo local real, com informação que só existe naquela página, contra template preenchido por variável.
Abuso de texto e link oculto
Abuso de texto ou link oculto é colocar conteúdo na página exclusivamente para manipular mecanismos de busca, sem que ele seja facilmente visível para visitantes humanos. Os exemplos incluem texto branco em fundo branco, texto escondido atrás de imagem, texto posicionado fora da tela por CSS, tamanho de fonte ou opacidade definidos como zero, e link escondido em um caractere mínimo, como um hífen ou um ponto no meio de um parágrafo.
Essa é a política com a melhor lista de exceções, e ela vale mais que a lista de violações para quem constrói interface. A documentação afirma explicitamente que não violam as políticas conteúdo em accordion ou em guias que alterna entre mostrar e ocultar, apresentação de slides ou carrossel que cicla entre imagens ou parágrafos, dica de contexto que aparece na interação com um elemento, e texto acessível apenas a leitores de tela criado para melhorar a experiência de quem os usa. Ocultar conteúdo por padrão em componente de interface não é ocultar conteúdo do Google.
Spam por links
Spam por links é criar links de ou para um site com o objetivo principal de manipular a classificação. A lista de exemplos é a mais longa das políticas e cobre compra e venda de links, troca de bens ou serviços por links, envio de produto em troca de avaliação com link, trocas excessivas e páginas de parceiros feitas só para linkar em cruz, uso de programas automatizados para criar links, exigência contratual de link sem permitir que o dono do conteúdo qualifique a saída, publieditorial com link que passa crédito, links de diretório de baixa qualidade, links em widgets distribuídos, links em rodapé ou template de vários sites, e links otimizados em comentário ou assinatura de fórum.
A parte que costuma ser omitida na cobertura do assunto é a permissão. O Google entende que comprar e vender links é prática econômica normal na web para publicidade e patrocínio, e que esses links não violam as políticas desde que sejam qualificados com rel="nofollow" ou rel="sponsored" na tag <a>. Ou seja, o objeto da política não é o pagamento, é o crédito de classificação transferido sem sinalização.
Essa política tem uma raiz histórica documentada pelo próprio Google. A página Detecting spam do How Search Works conta que, depois da publicação do artigo sobre o PageRank em 1999, a resposta imediata do mercado foi pagar uns aos outros por links. A política de spam por links existe desde então porque a manipulação nasceu junto com a divulgação do mecanismo.
Abuso de conteúdo em escala
Abuso de conteúdo em escala ocorre quando muitas páginas são geradas com o objetivo principal de manipular a classificação, e não de ajudar usuários. A prática se caracteriza por criar grandes volumes de conteúdo não original com pouco ou nenhum valor, independentemente de como o conteúdo é criado.
Usar ferramentas de IA generativa para gerar muitas páginas sem agregar valor está na lista, e ao lado dele estão copiar feeds ou resultados de pesquisa para gerar páginas, inclusive com transformações automatizadas como sinonimização e tradução, agrupar conteúdo de várias páginas sem adicionar valor, criar vários sites para esconder a natureza dimensionada do conteúdo, e produzir páginas que fazem pouco sentido para o leitor mas contêm palavras-chave.
Escala mais ausência de valor original é o que define a violação. O critério nunca foi a ferramenta, e é por isso que a política se aplica igualmente a uma redação humana que publica cem variações de um mesmo texto. Quem está usando IA para produzir material para ser citado por sistemas de IA está atrás de originalidade, que é justamente o oposto do que a política descreve.
Abuso de reputação do site, ou parasite SEO
Abuso de reputação do site é publicar conteúdo de terceiros em um site host principalmente por causa dos indicadores de classificação que esse host já acumulou, de modo que o conteúdo ranqueie melhor do que conseguiria por conta própria. É a política que o mercado chama de parasite SEO, e o termo não é apenas jargão externo, o Google usa a expressão no comunicado institucional que a própria documentação linka a partir dessa seção.
Ter conteúdo de terceiros não é violação. A documentação é explícita ao listar o que não se enquadra: sites de serviços de notícias e de comunicados à imprensa, publicações que divulgaram conteúdo de outras publicações, sites de conteúdo gerado pelo usuário como fóruns e seções de comentários, colunas e artigos de opinião, conteúdo de terceiros do tipo publieditorial cujo objetivo é compartilhar o conteúdo diretamente com os leitores, e uso de links de afiliado ao longo da página com os links tratados adequadamente.
O que caracteriza a violação é a motivação de aproveitar o sinal alheio, não a origem externa do texto.
Quando há revisão humana, o Google avalia quanto controle o domínio host exerce sobre o conteúdo a partir de quatro fatores objetivos.
O primeiro é como o conteúdo é apresentado, ou seja, se design, formatação, tipografia e recursos de experiência são consistentes com o resto do domínio. O segundo é a qualidade, ou se a página tem problemas que não aparecem no domínio principal. O terceiro é a autoria declarada ou implícita, ou seja, se existe reconhecimento explícito de responsabilidade pelo conteúdo. O quarto é se o mesmo conteúdo aparece em outros sites de forma idêntica ou quase idêntica. Nenhum dos quatro é necessário nem suficiente isoladamente.
O ajuste de agosto de 2026 separou a fiscalização por região. O comunicado do Google diz que a mudança veio após discussão com a Comissão Europeia e vale desde 30 de agosto de 2026. Para quem pesquisa fora do Espaço Econômico Europeu, a ação manual continua afetando diretamente a parte do site atingida, e o resto do site segue intacto. Para quem pesquisa dentro do Espaço Econômico Europeu, o efeito da ação manual não se aplica, e a seção atingida pode ser separada nos sistemas do Google para que, ao longo do tempo, ranqueie de forma independente do resto do site.
Para sites brasileiros, a consequência prática é limitada a leitura de usuários no Brasil segue o regime de fora do Espaço Econômico Europeu. O que muda é que uma mesma página pode estar sob ação manual para parte do mundo e não para outra, porque a decisão passou a depender de onde está quem pesquisa.
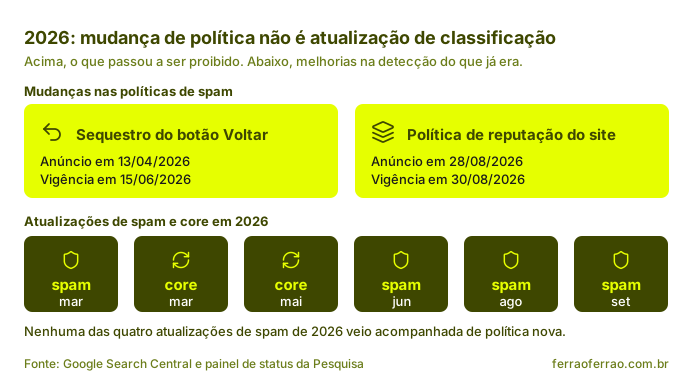
O que mudou nas políticas de spam em 2026
Duas políticas mudaram de texto em 2026, e nenhuma das quatro atualizações de spam do ano criou regra nova. Atualização de spam e mudança de política são coisas diferentes, a primeira melhora a detecção do que já é proibido, a segunda altera o que é proibido.
A primeira mudança foi anunciada em 13 de abril de 2026 e criou uma violação explícita dentro de práticas mal-intencionadas: o sequestro do botão Voltar, que acontece quando um site interfere na navegação manipulando o histórico do navegador ou outras funcionalidades e impede o usuário de voltar imediatamente à página anterior. O Google publicou a política dois meses antes da vigência, que começou em 15 de junho de 2026, e páginas nessa situação ficam sujeitas a ação manual ou a rebaixamento automático.
Essa política tem um detalhe que a torna relevante para quem não faz nada disso de propósito. O comunicado registra que algumas ocorrências de sequestro do botão Voltar podem se originar de bibliotecas incluídas no site ou da plataforma de anúncios, e não de código do próprio dono. A recomendação é revisar a implementação técnica e remover ou desativar qualquer código, importação ou configuração responsável pelo comportamento. Na prática, é uma política que se verifica testando o botão Voltar em uma página com anúncios, não lendo o código próprio.
A segunda mudança foi a da política de reputação do site anunciada em 28 de agosto de 2026 e vigente desde 30 de agosto de 2026.
As atualizações de classificação de 2026 são outra história, e o Google as registra no painel de status da Pesquisa, com nomes em inglês e com a duração preenchida somente quando o lançamento termina.
| Atualização | Início | Duração |
|---|---|---|
| Discover, fevereiro de 2026 | 5 de fevereiro | 21 dias e 17 horas |
| Spam, março de 2026 | 24 de março | 19 horas e 30 minutos |
| Core, março de 2026 | 27 de março | 12 dias e 4 horas |
| Core, maio de 2026 | 21 de maio | 11 dias e 21 horas |
| Spam, junho de 2026 | 24 de junho | 2 dias e 1 hora |
| Spam, agosto de 2026 | 18 de agosto | 2 dias e 16 horas |
| Spam, setembro de 2026 | 24 de setembro | em andamento |
As duas mais recentes seguiram o mesmo padrão. A de agosto de 2026 começou em 18 de agosto e levou 2 dias e 16 horas. A de setembro de 2026 foi lançada em 24 de setembro, com o aviso, no próprio painel, de que o lançamento pode levar até duas semanas para ser concluído, e até a consulta feita em 28 de setembro de 2026 o painel ainda não registrava o encerramento. As duas foram aplicadas globalmente e a todos os idiomas, nenhuma delas veio acompanhada de post no blog do Search Central e nenhuma anunciou política nova.
Isso significa que a régua de conformidade depois de setembro é a mesma de antes: as políticas listadas neste artigo. Uma atualização de spam muda a capacidade do Google de encontrar o que já era proibido, não a definição do que é proibido.
A duração varia muito e não indica intensidade. A atualização de spam de março de 2026 levou 19 horas e 30 minutos e a de agosto de 2025 levou 26 dias e 15 horas.
Como saber se o site foi penalizado
Há duas formas de perder posição por spam, e elas se diagnosticam de maneiras diferentes. A ação manual aparece nomeada no Search Console, e o rebaixamento algorítmico não aparece em nenhum relatório. Confundir as duas é o que faz alguém passar semanas procurando uma penalidade que não existe, quando o que houve foi uma atualização de classificação.
O volume explica por que o rebaixamento algorítmico é o caso mais comum. Segundo a página Detecting spam do How Search Works, os sistemas do Google encontram 40 bilhões de páginas com spam por dia, e a documentação afirma que os sistemas automatizados detectam a grande maioria do spam e o mantêm fora dos primeiros resultados. O que sobra é tratado manualmente pela equipe de remoção de spam, que revisa páginas e as sinaliza quando violam as políticas. O componente automatizado é o SpamBrain, descrito como o sistema de prevenção contra spam do Google baseado em IA, e as atualizações de spam são exatamente as melhorias importantes feitas nesse tipo de sistema.
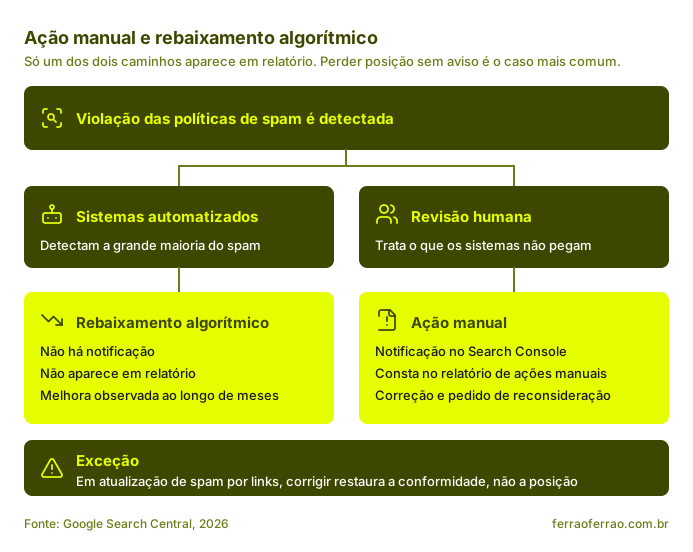
Se houve ação manual, o site é notificado, a violação aparece no relatório de ações manuais do Search Console, e depois de corrigir o problema o responsável pode enviar um pedido de reconsideração. A página Detecting spam afirma que o Google processa todos os pedidos de reconsideração que recebe.
Não há relatório equivalente para rebaixamento algorítmico, e é por isso que a ausência de ação manual no Search Console não é atestado de conformidade, significa apenas que nenhuma revisão humana registrou uma violação naquele site.
A recuperação é medida em meses. Fazer mudanças ajuda o site a melhorar se os sistemas automatizados observarem, ao longo de um período de meses, que ele obedece às políticas de spam. Não há botão de reset, e a expectativa de reversão em poucos dias depois de uma atualização de spam não tem base na documentação.
Há casos em que corrigir não recupera nada. No caso de uma atualização que trate especificamente de spam por links, as alterações talvez não gerem melhoria, porque quando os sistemas removem os efeitos dos links com spam, todo o benefício de classificação que aqueles links davam ao site é perdido, e esse benefício não é recuperável.
É a assimetria mais importante do assunto: a limpeza restaura a conformidade, não a posição. Quem comprou posição com links pagos não a recupera corrigindo o perfil de links depois.
Queda de posição tem várias origens, e boa parte delas não é penalidade: mudança de intenção da consulta, perda de rastreabilidade, problema de indexação, alteração na composição da página de resultados. É melhor confirmar que o rastreamento e a indexação estão íntegros antes de partir do princípio de que o problema é conformidade, porque o custo de tratar um problema técnico como penalidade é alto.
Perguntas frequentes sobre black hat SEO e políticas de spam
Usar IA para escrever conteúdo é black hat SEO?
Não por si só. A política de abuso de conteúdo em escala diz que a violação é gerar muitas páginas de conteúdo não original com pouco valor para o usuário, independentemente de como o conteúdo é criado. Ferramentas de IA generativa aparecem entre os exemplos, ao lado de práticas puramente humanas como agrupar conteúdo de várias páginas sem agregar valor. O que a política mira é a combinação de escala com ausência de valor original, não a ferramenta usada para escrever.
Comprar links é sempre violação das políticas de spam?
Não. A documentação afirma que comprar e vender links é prática econômica normal na web para publicidade e patrocínio, e que esses links não violam as políticas desde que qualificados com rel="nofollow" ou rel="sponsored" na tag <a>. A violação está em transferir crédito de classificação por pagamento sem sinalizar, o que inclui publieditoriais, links de texto que não bloqueiam crédito e envio de produto em troca de avaliação com link.
As atualizações de spam de agosto e setembro de 2026 criaram regras novas?
Não. A de agosto começou em 18 de agosto e levou 2 dias e 16 horas. A de setembro foi lançada em 24 de setembro, com previsão de até duas semanas de implantação. Nenhuma das duas veio acompanhada de post no blog do Search Central nem anunciou política nova. As duas mudanças de política de 2026 foram outras: o sequestro do botão Voltar, vigente desde 15 de junho, e o ajuste da política de reputação do site, vigente desde 30 de agosto.
Verificar posição com ferramenta de SEO viola as políticas do Google?
A política de tráfego gerado por máquina afirma que enviar consultas automatizadas ao Google, incluindo raspar resultados para verificar classificação, sem permissão expressa viola as políticas de spam e os Termos de Serviço do Google. A política trata do consumo de recursos da Pesquisa, não da qualidade do site que consulta, e é a única da lista cujo alvo é o comportamento de quem faz a busca e não o conteúdo publicado.
Quanto tempo leva para recuperar posição depois de corrigir uma violação?
A documentação fala em um período de meses de observação pelos sistemas automatizados antes de o site melhorar, sem prazo fixo. Se houve ação manual, o pedido de reconsideração acelera a revisão do caso, mas não a reconstrução dos sinais. E se a perda veio de uma atualização que tratou de spam por links, o benefício que aqueles links davam foi removido e não retorna com a correção.
Conclusão
A lista de práticas de black hat SEO é pública, nomeada e verificável, e é mais curta do que a discussão em torno dela sugere: dezesseis políticas, mais quatro situações de rebaixamento e remoção. A leitura útil delas não é decorar a lista, é entender que quase todas se resolvem pela mesma pergunta, a de qual é o objetivo principal da prática. Entregar conteúdo diferente ao Googlebot por limitação técnica é um problema de renderização; fazer o mesmo para manipular posição é cloaking. Publicar conteúdo de terceiros é normal; publicá-lo para aproveitar o sinal do host é abuso de reputação do site. A intenção é o critério, e é ela que a documentação repete em quase toda definição.
O próximo passo prático é conferir o relatório de ações manuais do seu Search Console para saber se há alguma violação registrada, e, na ausência dela, verificar rastreabilidade e indexação antes de atribuir qualquer queda de posição a conformidade. Se a sua dúvida é sobre uma prática específica, vale ler a política pelo nome dela na documentação, e em inglês quando o assunto for reputação do site, ao menos até a versão em português sincronizar.